
Wer ein neues Projekt mit Claude, ChatGPT oder Gemini beginnt, hat nach wenigen Tagen erstaunlich viel Material: Konzeptnotizen, Markdown-Dateien, Zusammenfassungen, eine lange Commit-Historie. Und oft das Gefühl, den Überblick verloren zu haben. Diese Erfahrung mache ich seit Monaten immer wieder, in eigenen Projekten wie im Team.
Dahinter steht oft eine Erwartung: Die AI wird das schon machen. Man verlässt sich darauf, ohne ein eigenes Ordnungssystem im Kopf zu haben oder eines aufgebaut zu haben.
Meine Arbeitshypothese dazu ist bewusst zugespitzt:
AI beschleunigt, was da ist, auch die Unordnung. Mit einem Ordnungssystem nimmt sie Routine ab. Ohne eines erzeugt sie in kurzer Zeit mehr Material, als man einsortieren kann, und die Unordnung wächst schneller als ohne AI. Beim Finden eines Ordnungssystems hilft sie, ersetzen kann sie es nicht.
Das betrifft alle großen LLM-Tools, ob Claude, ChatGPT, Gemini, Copilot oder ein selbst gehostetes Modell. Meine eigenen Erfahrungen stammen allerdings überwiegend aus Claude Code und Cursor mit Modellen von Anthropic (zu den Unterschieden siehe Claude Code vs. Cursor). Die Beispiele aus meinem Alltag sind deshalb kein Vergleich der Anbieter. Die Studien weiter unten decken auch ChatGPT, Gemini und Copilot ab. Im Folgenden stehen diese Beispiele, die Studienlage dazu, ein Vorschlag, wie man AI in ein bestehendes System einbaut, und eine offene Frage, die mich seit der Recherche beschäftigt.
Wie entsteht mit AI so schnell Unordnung?
AI erzeugt Inhalte schneller, als man sie einsortieren kann, und jede Session wählt ihre eigene Ablage, wenn keine vorgegeben ist. Ohne feste Struktur wächst deshalb mit dem Output auch das Durcheinander, und zwar in Tagen statt in Wochen.
Ein typischer Verlauf in neuen Projekten: Man lässt Anforderungen, Entscheidungen und Analysen als Markdown aufschreiben. Nach kurzer Zeit sieht der docs-Ordner etwa so aus, teils doppelt, teils widersprüchlich:
docs/
├── ANALYSIS.md
├── analysis-datenmodell.md
├── implementation-plan.md
├── implementation-plan-v2.md
├── NOTES.md
├── NOTES_final.md
└── zusammenfassung-sprint-3.md
Dann folgt der Aufräum-Prompt: „Organisieren wir den Docs-Ordner.“ Das Ergebnis ist eine saubere Struktur, zeitlich, thematisch, nach Dokumenttyp, zum Beispiel:
docs/
├── analysen/
│   └── datenmodell.md
├── entscheidungen/
│   └── 2026-09-12-datenbank.md
├── konzepte/
│   └── implementierungsplan.md
└── notizen/
    └── 2026-09-sprint-3.md
Halten wird diese Struktur nur, wenn sie als Regel festgeschrieben ist, etwa in einer CLAUDE.md oder AGENTS.md, die jede neue Session lädt. Welche Struktur gilt, muss man dabei selbst entscheiden. Fragt man die AI dreimal nach einer Gliederung, bekommt man meist drei verschiedene Vorschläge, die alle plausibel sind.
Auch eine festgeschriebene Struktur verliert mit der Zeit an Konsistenz. Die AI ändert gezielt einzelne Stellen, und danach passt das Gesamtdokument oft nicht mehr ganz zusammen: Aussagen widersprechen sich, Inhalte tauchen doppelt auf. Bewährt hat sich bei mir deshalb ein wiederkehrender Schritt: ein kompletter Review, ob die Dokumentation in sich schlüssig und konsistent ist. Systemisch gelöst habe ich das bisher nicht, ich stoße diesen Review noch von Hand an.
Ähnlich bei Commits. Agents committen gern in kleinen Schritten ohne erkennbaren Zusammenhang: Fix, Folge-Fix, Formatierung, noch ein Fix. Dass Änderungen zu einem Thema in einen Commit gehören und wie eine Message aufgebaut ist, muss man dem Agenten beibringen. In unserem Regelwerk bei form4 steht dafür eine feste Regel: Ungepushte Commits zum selben Thema werden vor der Abgabe zusammengefasst, bei längeren Ketten schlägt der Agent das vor. Das ist Methodik, und die muss vor dem Einsatz der AI feststehen.
Kann AI einem Projektleiter sagen, was heute wichtig ist?
Nur, wenn es ein Regelwerk gibt, nach dem Wichtigkeit bewertet wird. Ohne ein solches Regelwerk fasst die AI zusammen, was in Tickets, Mails und Chats steht, und gewichtet nach Kriterien, die niemand kennt und die sich nicht prüfen lassen.
Ein Muster, das ich bei Projektleitern beobachtet habe: Die AI wird an Ticketsystem, Mail-Postfach, Chat und Kalender angeschlossen, und der Tag beginnt mit dem Prompt „Sag mir, was ich zu tun habe.“ Technisch funktioniert das. Die Antwort ist gut formatiert, klingt plausibel und enthält eine Prioritätenliste.
Ob diese Liste stimmt, lässt sich kaum beurteilen. Ein Projektleiter hat Quellen mit sehr unterschiedlicher Verbindlichkeit: Tickets mit Fälligkeit, Kundenmails, Chat-Nachrichten aus dem Team, Meeting-Notizen, Memos. Welche davon heute zählt, hängt von Vereinbarungen, Eskalationswegen und Kontext ab, der oft in keiner dieser Quellen steht. Vermutlich würden auch zwei erfahrene Menschen hier nicht dieselbe Liste aufschreiben.
Dazu kommt, dass Sprachmodelle beim Wiedergeben und Verdichten von Informationen messbar Fehler machen. In der Studie News Integrity in AI Assistants der EBU und BBC (Oktober 2025) prüften Journalisten aus 22 öffentlich-rechtlichen Medienhäusern über 3.000 Antworten von ChatGPT, Copilot, Gemini und Perplexity. In der Kernauswertung mit rund 2.700 Antworten enthielten 45 % mindestens ein signifikantes Problem, 20 % signifikante Fehler bei der Genauigkeit. Eine Prioritätenliste aus dem Postfach ist genau so eine Verdichtung, nur ohne Journalisten, die sie prüfen.
Es gibt auch einen Gegenbefund, und er passt zur These. In einer Studie mit 150 simulierten Patientennachrichten stimmte GPT-4 bei der Dringlichkeitseinstufung in 93 % der Fälle mit Nephrologen überein. Die Nachrichten waren simuliert und eindeutig formuliert, die Dringlichkeitsstufen hatten Fachleute vorab definiert. Das spricht dafür, dass AI-Triage mit einem klaren Bewertungsschema gut funktioniert, das Schema selbst muss aber jemand liefern.
Für die persönliche Organisation gibt es solche Schemata seit Langem. Getting Things Done von David Allen (2001, überarbeitet 2015) gliedert die Arbeit in fünf Schritte: Capture, Clarify, Organize, Reflect, Engage. Für Prioritäten ist vor allem Clarify relevant: Für jeden Eingang wird geklärt, ob er eine Aktion erfordert und was der nächste konkrete Schritt ist. Eine AI kann beim Einsammeln und Vorsortieren helfen. Die Kriterien für diese Klärung und die regelmäßige Durchsicht legt der Mensch fest.
Damit ist nicht gesagt, dass „Sag mir, was ich zu tun habe“ nie funktionieren kann. Ich bin mir aber bei weitem nicht sicher, dass eine AI ohne vorgegebene Kriterien korrekt, vollständig und fehlerfrei wiedergibt, was die tatsächlichen Prioritäten sind.
Was sagen Studien über AI und vorhandene Strukturen?
Die größeren Studien der letzten Jahre zeigen ein konsistentes Muster: AI wirkt stark, wo Abläufe etabliert und aufgeschrieben sind, und schwach oder schädlich, wo sie fehlen oder nur im Kopf existieren. Drei Befunde tragen die These, einer widerspricht ihr auf den ersten Blick.
Die Programmierung sollte der Idealfall sein. Programmiersprachen sind formale, deterministische Systeme mit fester Syntax und eindeutiger Semantik, und ob Code tut, was er soll, lässt sich mit Compiler, Linter und Tests maschinell prüfen. Ein Coding-Agent bekommt diese Rückmeldung in jeder Iteration und kann sich daran korrigieren. Dass AI beim Programmieren so gut funktioniert, sehe ich als Beleg dafür, wie sehr ein festes, prüfbares Schema hilft. Die METR-Studie weiter unten zeigt allerdings, dass das allein nicht reicht.
DORA 2025. Der State of AI-assisted Software Development Report von Google basiert auf knapp 5.000 Befragten. Die Kernaussage der Autoren: „AI doesn't fix a team; it amplifies what's already there.“ Starke Teams werden mit AI effizienter, schwache Teams sehen ihre Probleme verstärkt. AI-Einsatz hängt positiv mit Durchsatz zusammen und weiterhin negativ mit der Stabilität von Auslieferungen. Mehr Output, mehr Instabilität: Das ist die Beschleunigung der Unordnung in Zahlen. Das DORA AI Capabilities Model nennt sieben Fähigkeiten, die den Nutzen von AI erhöhen, darunter starke Versionskontrolle, Arbeiten in kleinen Batches, AI-zugängliche interne Daten und hochwertige interne Plattformen. Das sind technische und organisatorische Voraussetzungen, keine Eigenschaften des Modells.
Jagged Frontier. In einem Feldexperiment mit 758 BCG-Beratern (Dell'Acqua et al., Organization Science 2026) erledigten die Teilnehmer mit GPT-4 Aufgaben innerhalb der Fähigkeiten des Modells 25,1 % schneller und mit rund 30 % besser bewerteten Ergebnissen. Bei einer Aufgabe außerhalb dieser Grenze kamen sie mit AI um 19 Prozentpunkte seltener zur richtigen Lösung als ohne. Die AI hat dort nichts weggelassen, sie hat Fehler erzeugt, die ohne sie nicht entstanden wären. Wer nicht einschätzen kann, wo die Grenze liegt, verschlechtert sich.
METR 2025. In einer randomisierten Studie mit 16 erfahrenen Open-Source-Entwicklern brauchten diese mit AI 19 % länger, schätzten hinterher aber, AI habe sie um 20 % beschleunigt. Auf den ersten Blick widerspricht das dem Bild vom Programmieren als Idealfall. Die Faktorenanalyse der Autoren zeigt, warum es dazu passt: Die Entwickler arbeiteten im Schnitt seit fünf Jahren und 1.500 Commits in ihren Repositories, die Repositories waren im Schnitt zehn Jahre alt mit über 1,1 Millionen Zeilen Code. Als einen Grund für die Verlangsamung nennt METR den impliziten Repository-Kontext: Entwickler verlassen sich auf undokumentiertes Wissen über die Codebasis, und der AI fehlt dieses Wissen. Ein Teilnehmer beschreibt, dass die AI sich wie ein neuer Mitarbeiter im Projekt verhält, ein anderer: „It doesn't know we need to take care of this weird case of backwards compatibility and keep this specific line. And this is very hard to give as context to the model.“ Die Struktur war also da, aber nur im Kopf. Compiler, Linter und Tests haben nicht gereicht, weil die Konventionen, die zählten, nirgends standen. Das ist für mich der stärkste Beleg dafür, dass ein Ordnungssystem aufgeschrieben sein muss. Die Autoren selbst schreiben, dass die Vertrautheit mit dem Repository zur Verlangsamung beiträgt und dass kleine Greenfield-Projekte und fremde Codebasen vermutlich deutlich profitieren. METR markiert die Zahlen inzwischen als veraltet und hält heutige Tools für hilfreicher, eine belastbare neue Zahl gibt es aber noch nicht. Was bleibt, ist die Wahrnehmungslücke: Gefühlt geht es auch bei mir schneller, und genau vor dieser Selbsteinschätzung warnt die Studie.
Generative AI at Work. Der Gegenbefund: In der Studie von Brynjolfsson, Li und Raymond mit rund 5.000 Support-Mitarbeitern (QJE 2025) stieg die Produktivität im Schnitt um 15 %, bei weniger erfahrenen und weniger qualifizierten Kräften um rund 30 %. AI hilft also gerade denen, die noch kein eigenes System haben. Die Autoren vermuten, dass das Tool die Arbeitsweise der besten Mitarbeiter weitergibt. Dann kam die Struktur aus den Best Practices anderer, und die These hält. Sicher ist das nicht, die Studie misst den Mechanismus nicht direkt.
Welche Methodiken geben AI die nötige Struktur?
Bewährte Methodiken, die explizit festlegen, was wohin gehört und wann etwas fertig ist. In der Softwareentwicklung sind das zum Beispiel Domain-Driven Design, arc42 und Spec-driven Development, in der Selbstorganisation GTD. Sie sind verbindlicher als jeder Prompt und geben der AI ein Gerüst, an dem sie sich ausrichten kann.
In der Softwareentwicklung arbeite ich ohnehin so. Für Architektur schaue ich, welche Muster es gibt, für Spezifikationen, welche Vorlagen sich bewährt haben:
- Domain-Driven Design beschreibt Eric Evans seit 2003, die Konzepte dahinter tragen bis heute.
- arc42 von Gernot Starke und Peter Hruschka gibt es seit 2005. Zwölf Abschnitte legen fest, welche Information über eine Architektur wohin gehört.
- Spec-driven Development hat mit GitHubs Spec Kit (September 2025) ein eigenes Werkzeug bekommen. Die Begründung im Launch-Post: Coding-Agents „excel at pattern recognition but still need unambiguous instructions“.
Bei form4 läuft die Entwicklung entsprechend über eine feste Kette: Ticket, Spezifikation mit Akzeptanzkriterien, Review-Gate, agentische Umsetzung (mehr dazu in Von MDA zu AI-driven Development). Die Regeln dafür liegen versioniert in einem zentralen Repository, projektspezifische in der CLAUDE.md des Projekts, damit jede Agent-Session nach denselben Vorgaben arbeitet.
Solche Modelle muss man nicht alle kennen, bevor man anfängt. Hier liegt aus meiner Sicht der sinnvollste Einsatz von AI beim Thema Ordnung: Sie kennt den Katalog der etablierten Systeme und kann ihn auf die eigene Situation anwenden, wenn man gezielt danach fragt. Welche etablierten Modelle gibt es für Dokumentation, Commit-Messages oder die Priorisierung von Aufgaben, wer setzt sie ein und wo liegen ihre Grenzen? Das ist eine andere Frage als die offene Bitte um eine Gliederung aus dem ersten Abschnitt. Meine Vermutung ist, dass die Antworten stabiler ausfallen, weil verbreitete Standards wie arc42, Conventional Commits oder GTD gut dokumentiert sind und die AI sie nicht neu erfinden muss. Das passt zum Befund von Brynjolfsson und Kollegen, wo die Struktur ebenfalls aus den bewährten Praktiken anderer kam. Danach kann die AI Methoden vergleichen, ein Regelwerk entwerfen und Vorlagen schreiben. Ob ein Standard passt, prüft man an der Originalquelle, und die Entscheidung für ein System bleibt beim Menschen.
Woher kommen die nächsten Methodiken?
Aus der Erfahrung von Menschen, die lange genug in einem Fach gearbeitet haben, um Muster zu erkennen und aufzuschreiben. Ob dieser Nachschub bleibt, wenn ein großer Teil der Arbeit an AI geht, ist für mich die offene Frage hinter diesem Post.
Domain-Driven Design, arc42 und GTD sind Destillate aus der Praxis ihrer Autoren. Die Studien oben zeigen, dass auch die AI von genau dieser Art Erfahrung lebt: Bei Brynjolfsson und Kollegen gibt sie die Arbeitsweise der besten Mitarbeiter weiter. Bei METR fehlt ihr das Wissen, das Entwickler in fünf Jahren und 1.500 Commits aufgebaut haben. In beiden Fällen stammt die Struktur von Menschen, die sie vorher erarbeitet haben.
Wenn Berufseinsteiger die Routineaufgaben, an denen man früher Muster gelernt hat, an einen Agenten geben, sammeln sie diese Erfahrung langsamer oder gar nicht. Dann gibt es irgendwann weniger Menschen, die ein neues Ordnungssystem aus eigener Anschauung entwerfen könnten, und die AI gibt weiter, was schon vorhanden ist. Das ist eine Vermutung, keine Messung, und vielleicht entstehen Methodiken künftig auf anderem Weg, etwa aus der Auswertung vieler Agent-Sessions. Für mich ist es trotzdem der Grund, eigene Regelwerke ernsthaft zu pflegen: Sie sind der Ort, an dem neue Erfahrung noch festgehalten wird, bevor sie in der nächsten Session verloren geht.
Wie setzt man AI in einem Ordnungssystem sinnvoll ein?
Zuerst das System, dann die AI: ein klares Modell mit Zielen, Gates und Messmethoden, in dem AI die Aufgaben übernimmt, bei denen sie nachweislich stark ist. Verlässlich wird sie erst, wenn ihre Ergebnisse gegen dieses Modell geprüft werden.
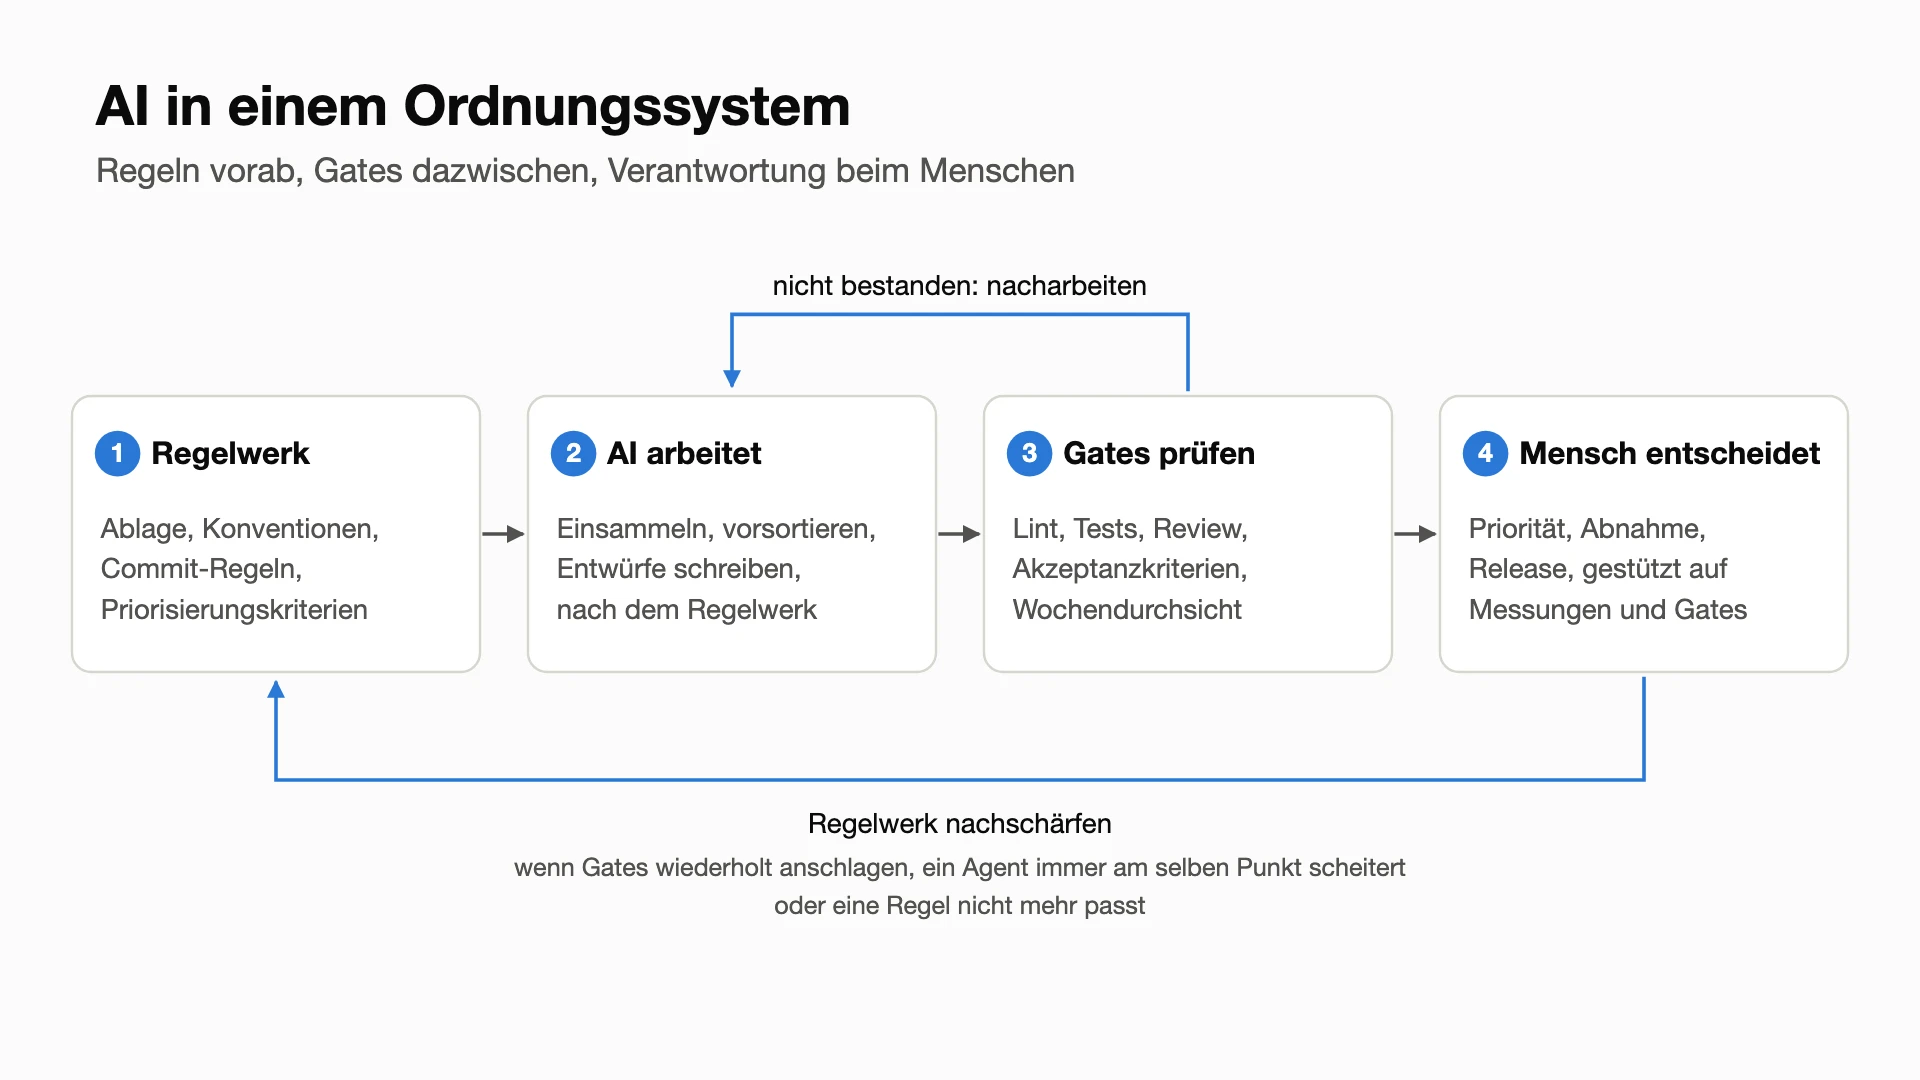
- Regelwerk aufschreiben. Ablage, Namenskonventionen, Commit-Regeln, Priorisierungskriterien. Was nur im Kopf existiert, kann keine Session laden. Die METR-Entwickler hatten ein Ordnungssystem, es stand nur nirgends.
- AI dort einsetzen, wo sie stark ist. Einsammeln, nach dem vorgegebenen Schema vorsortieren, Konventionen durchsetzen, Entwürfe schreiben.
- Gegen Gates prüfen und messen. In der Entwicklung Lint, Tests, Review und Akzeptanzkriterien, in der Organisation eine feste Wochendurchsicht, bei der die Listen gegen die Realität abgeglichen werden.
- Gesteuert automatisieren, selbst verantworten. Priorität, Abnahme und Release werden durch Messungen vorbereitet, die auch die AI durchführt, und durch Automatisierung, die gezielt eingesetzt und über Gates geführt ist. Die letzte Entscheidung trifft der Mensch.
Ein Ordnungssystem ist nie fertig. Modelle und Tools ändern sich in kurzen Abständen, die METR-Zahlen von Anfang 2025 waren nach einem Jahr veraltet. Bei form4 liegen Regeln, Rollen und Workflows deshalb zentral und versioniert in einer gemeinsamen agentischen Entwicklungsplattform. Sagt man in einer Session, dass etwas künftig gelten soll, schreibt der Agent es als Regel ins zentrale Repository, und nach dem nächsten Plugin-Update gilt sie im ganzen Team. Den Anstoß gibt aber oft der Mensch: wenn ein Agent wiederholt am selben Punkt scheitert, eine Regel nicht mehr passt oder ein neues Projekt eine Lücke zeigt. Hilfreich ist dafür, die eigene Nutzung regelmäßig auswerten zu lassen. Claude Code fasst mit /insights die letzten Sessions zusammen: woran man arbeitet, wo es hakt, etwa bei missverstandenen Anfragen, und was man anders nutzen könnte. /doctor prüft zusätzlich das Setup samt CLAUDE.md. Andere Tools haben vermutlich Vergleichbares, GitHub Copilot CLI etwa mit /chronicle. Diese Auswertung zeigt Lücken im Regelwerk, die man selbst übersieht.
Ein kleines Beispiel ist dieses Blog. Die Schreibregeln stehen in einer AGENTS.md, und ein Audit-Skript prüft in der CI-Pipeline bei jedem Push, ob Meta-Beschreibung, Permalink, Verlinkung und Quellenbelege den Regeln entsprechen. Die AI schreibt Entwürfe, das Skript ist das Gate, und veröffentlicht wird erst, wenn ich den Text freigebe.
Fazit
AI-Tools sind kein Ersatz für Methodik. Sie setzen gelernte Arbeitsweisen nicht außer Kraft und bringen sie auch niemandem nebenbei bei. Für mich ist das ein laufender Lernprozess, mein aktueller Stand in Stichpunkten:
- AI beschleunigt, was da ist, auch die Unordnung. Mit einem Ordnungssystem nimmt sie Routine ab. Ohne eines liefert sie mehr Material in kürzerer Zeit, und DORA misst dazu mehr Durchsatz bei weniger Stabilität.
- Struktur schriftlich festlegen, implizites Wissen zählt nicht. Ablage, Commit-Konvention und Priorisierungskriterien gehören in eine Datei wie
CLAUDE.mdoderAGENTS.md, die jede Session lädt. Die METR-Entwickler hatten fünf Jahre Erfahrung im Repository, und die AI hat sie trotzdem gebremst, weil dieses Wissen nirgends stand. - Beim Finden des Systems hilft AI, beim Entscheiden nicht. Gezielt nach etablierten Standards wie GTD, Domain-Driven Design, arc42 oder Spec-driven Development gefragt, liefert sie den Katalog. Welches System gilt, entscheidet der Mensch, und er prüft die Ergebnisse gegen Gates wie Lint, Tests, Review und eine feste Wochendurchsicht.
- Die Methodiken von morgen brauchen Menschen, die heute Erfahrung sammeln. Die AI gibt weiter, was andere erarbeitet haben. Eigene Regelwerke zu pflegen hält diese Erfahrung fest.
Für den Einstieg hilft ein einfacher Test: die eigene Ablage, die Priorisierungsregeln oder die Commit-Konvention auf eine Seite schreiben, bevor man sie der AI gibt. Gelingt das nicht, fehlt das Ordnungssystem noch, und dort sollte man ansetzen, bevor man am nächsten Prompt feilt.